Databricks
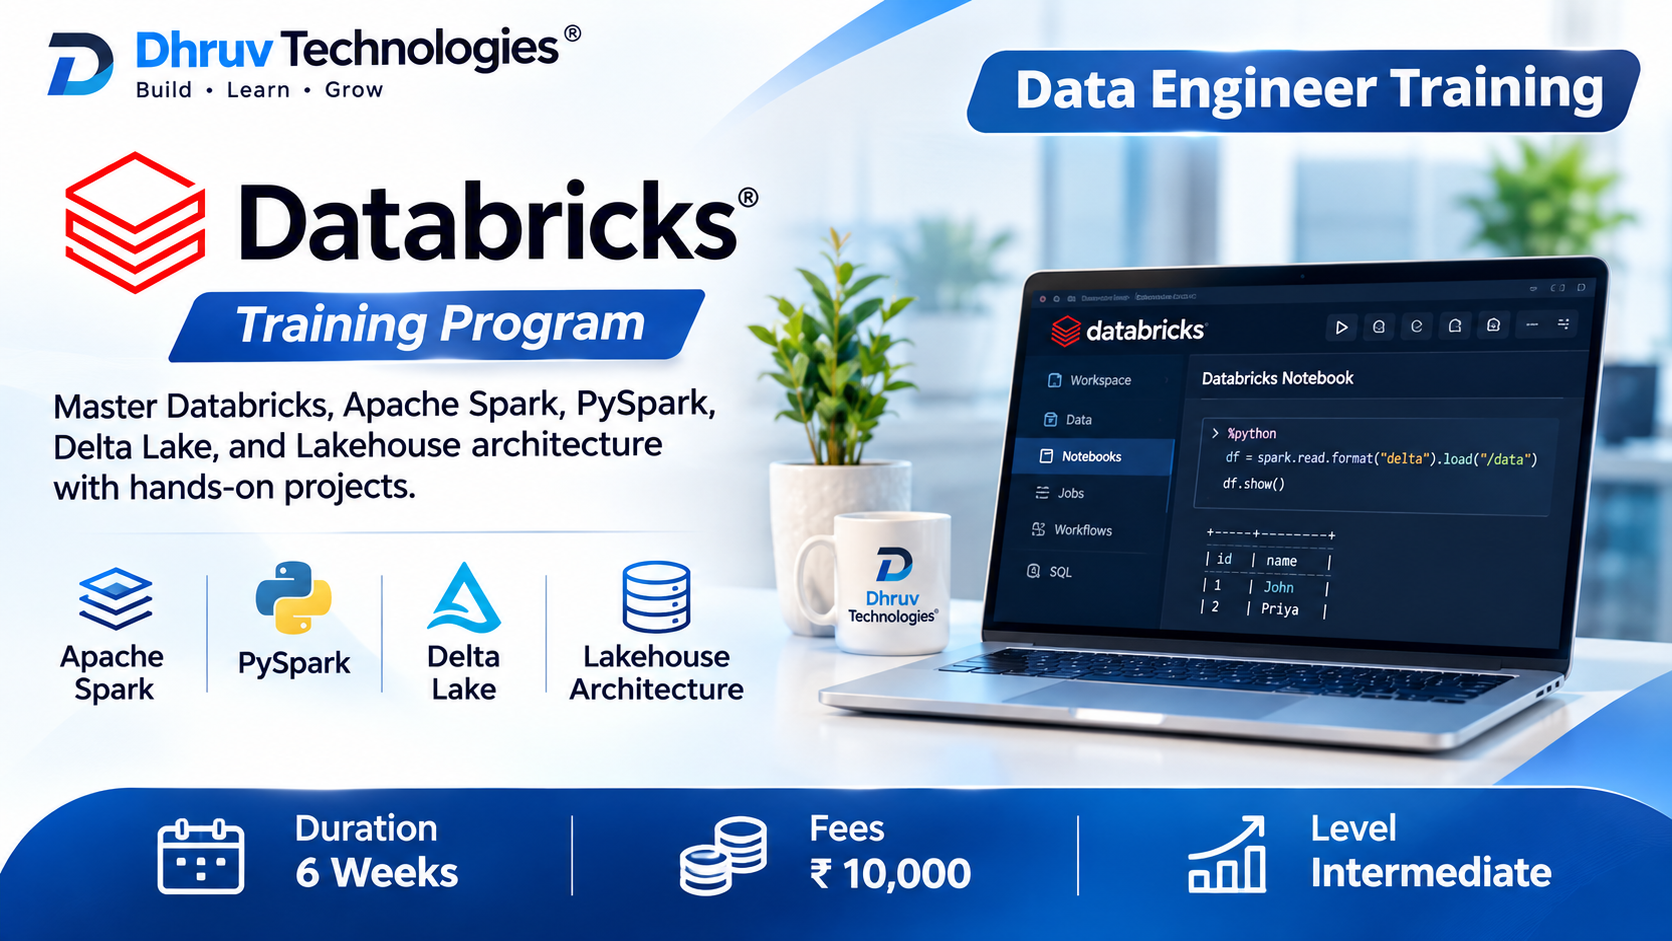
Master Databricks, Apache Spark, PySpark, data engineering, lakehouse architecture, and big data processing through hands-on practical training.
Course Description
The Databricks Training Program provides comprehensive knowledge of modern data engineering and big data processing. Students will learn Databricks workspace, Apache Spark, PySpark, Delta Lake, data ingestion, data transformation, and Lakehouse architecture.
The course focuses on developing scalable data pipelines and processing large datasets efficiently. Learners will gain practical experience in working with notebooks, managing data, optimizing queries, and building data engineering workflows.
Trainer
N
Navdeep Singh
Data Analytics and Enterprise Data Architecture
20 years experience
Experienced Data Analytics Trainer with expertise in transforming raw data into actionable business insights. Skilled in data visualization, statistical analysis, business intelligence, and reporting....
Technologies Covered
Databricks
Apache Spark
PySpark
Delta Lake
Python
SQL
Lakehouse Architecture
Data Pipelines
Projects
- End-to-End Data Engineering Pipeline
- Big Data Processing Using PySpark
- Real-Time Data Processing Project
- Delta Lake Data Management
FAQ
Databricks is a unified data and AI platform used for big data processing, data engineering, analytics, machine learning, and building data pipelines
Basic Python knowledge is beneficial because PySpark uses Python for distributed data processing. SQL is also important.
You can explore opportunities such as Databricks Developer, Data Engineer, Big Data Engineer, and PySpark Developer.